

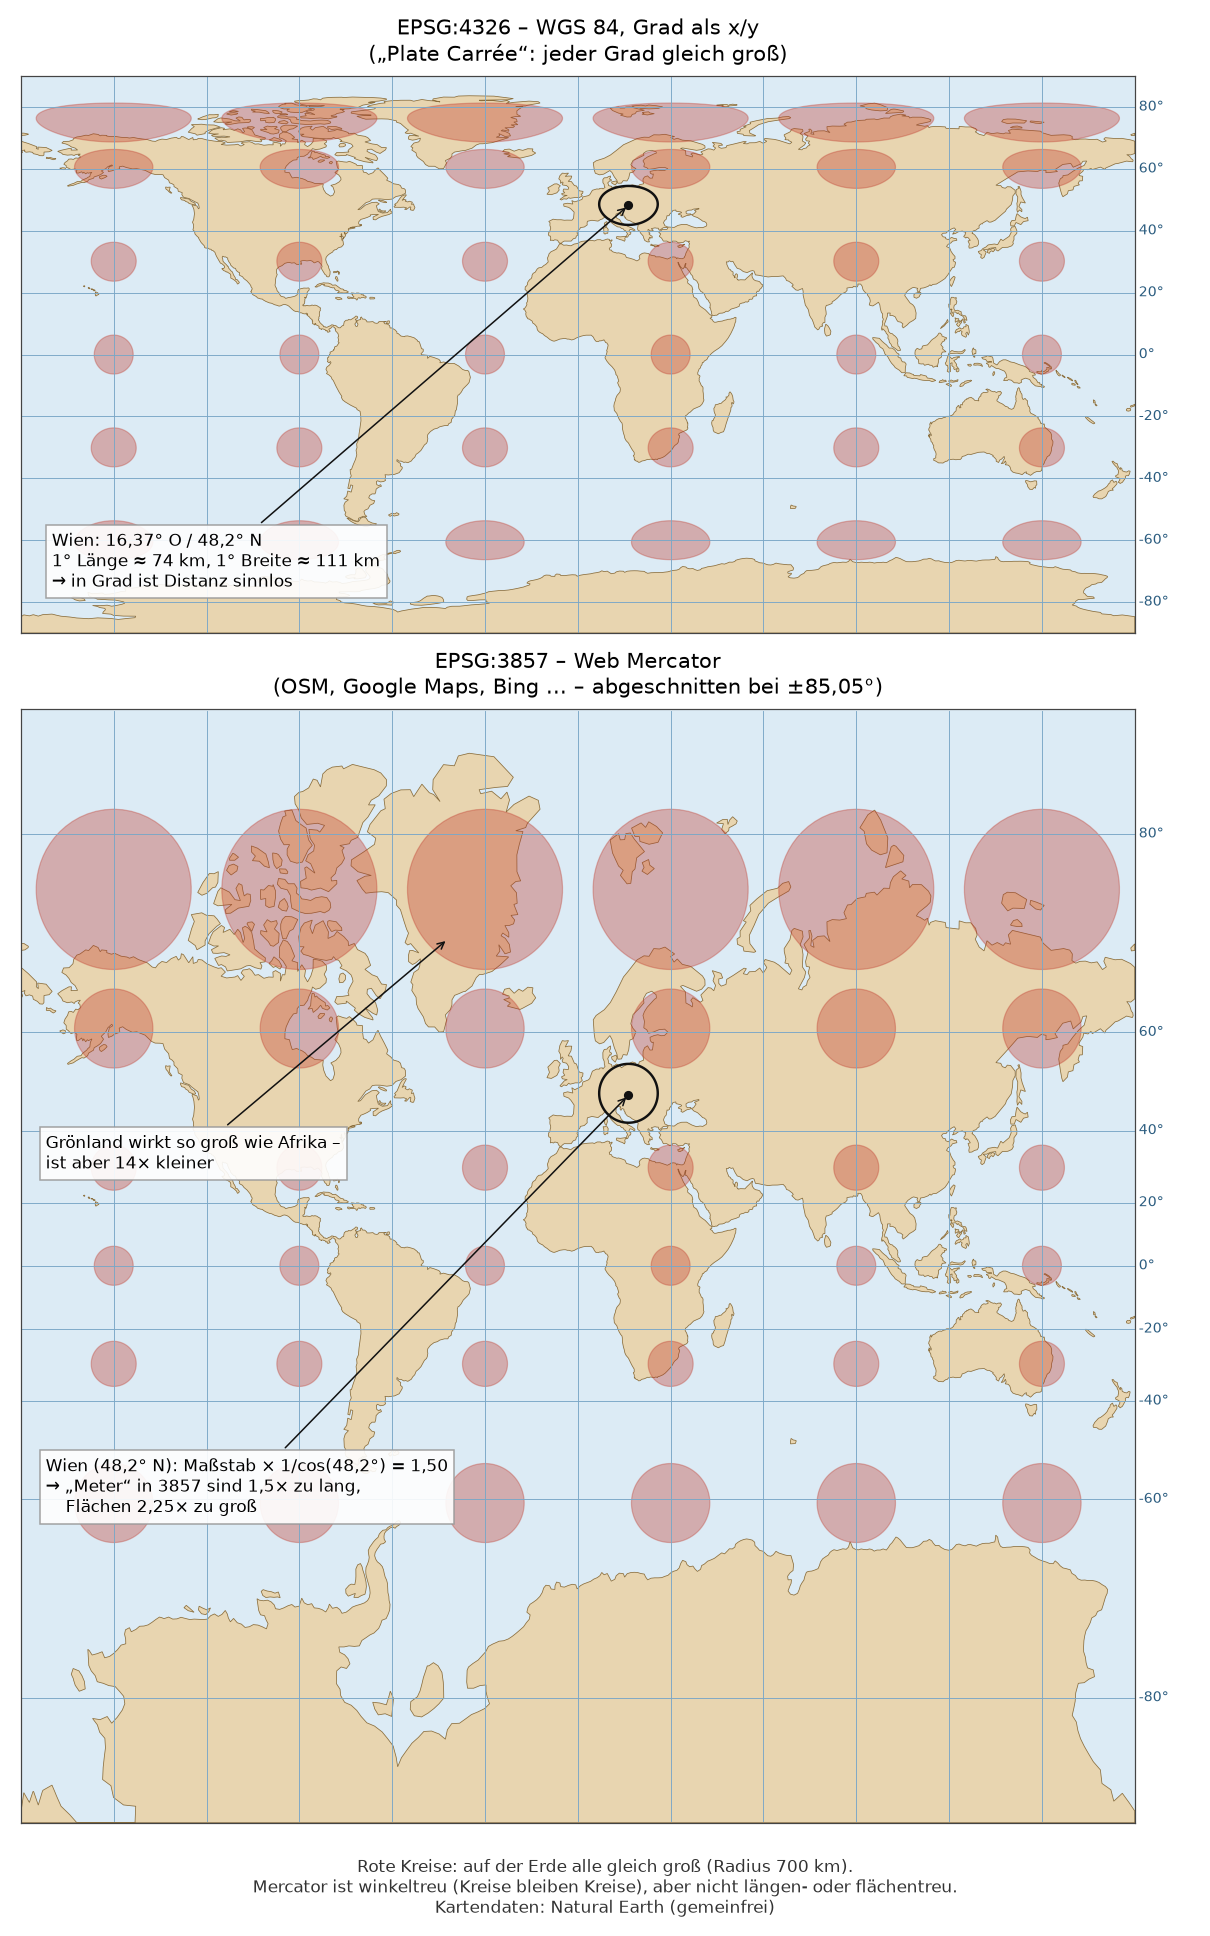
Alle Haltepunkte des Wiener öffentlichen Verkehrs von data.gv.at nach PostgreSQL 18 mit PostGIS: Rolle gisuser, Datenbank hs, Import per \copy, räumliche Abfragen, Geocodierung mit Nominatim und eine Erreichbarkeitskarte in QGIS – dazu, warum EPSG:4326, EPSG:3857 und die Gauß-Krüger-Systeme von NÖ Atlas und DORIS nicht dasselbe sind. Für Ubuntu, macOS und Windows (WSL 2), mit Test nach jedem Schritt.
RAG mit PostgreSQL, pgvector und Ollama: das VPI-Beispiel Schritt für Schritt (Ubuntu, macOS & Windows/WSL)
Ein lokales RAG-System für österreichische Verbraucherpreisdaten: PostgreSQL 18 mit pgvector, Rolle raguser, Embeddings mit all-MiniLM-L6-v2 und Qwen 3 über Ollama – Schritt für Schritt für Ubuntu, macOS und Windows (WSL 2), mit Test nach jedem Schritt.

Kundensegmente & Prognose von Kaufverhalten
Neuproduktentwicklung Reighungsfragen, die nichts anderes repräsentieren als Präferenzen werden in Gruppen mit ähnlichen Präferenzen zusammengefasst. Diesen Segmentierungsprozess erldigt die Kmeans-Clusteranalyse. Jede Beobachtung (xi) wir einem […]
Der Einfluss der YouTube-Headline auf die Anzahl der zu erwartenden ‚Views‘.
Kombiniere die Fähigkeit von Large Language Models mit klassischem Machine-Learning.
Kursprognose von Aktien
by DI Klaus HILBE Das Ziel dieses Projektes ist auf Basis der Kursprognose von Aktien einen Einblick in die Welt der Künstlichen Intelligenz (KI) zu […]
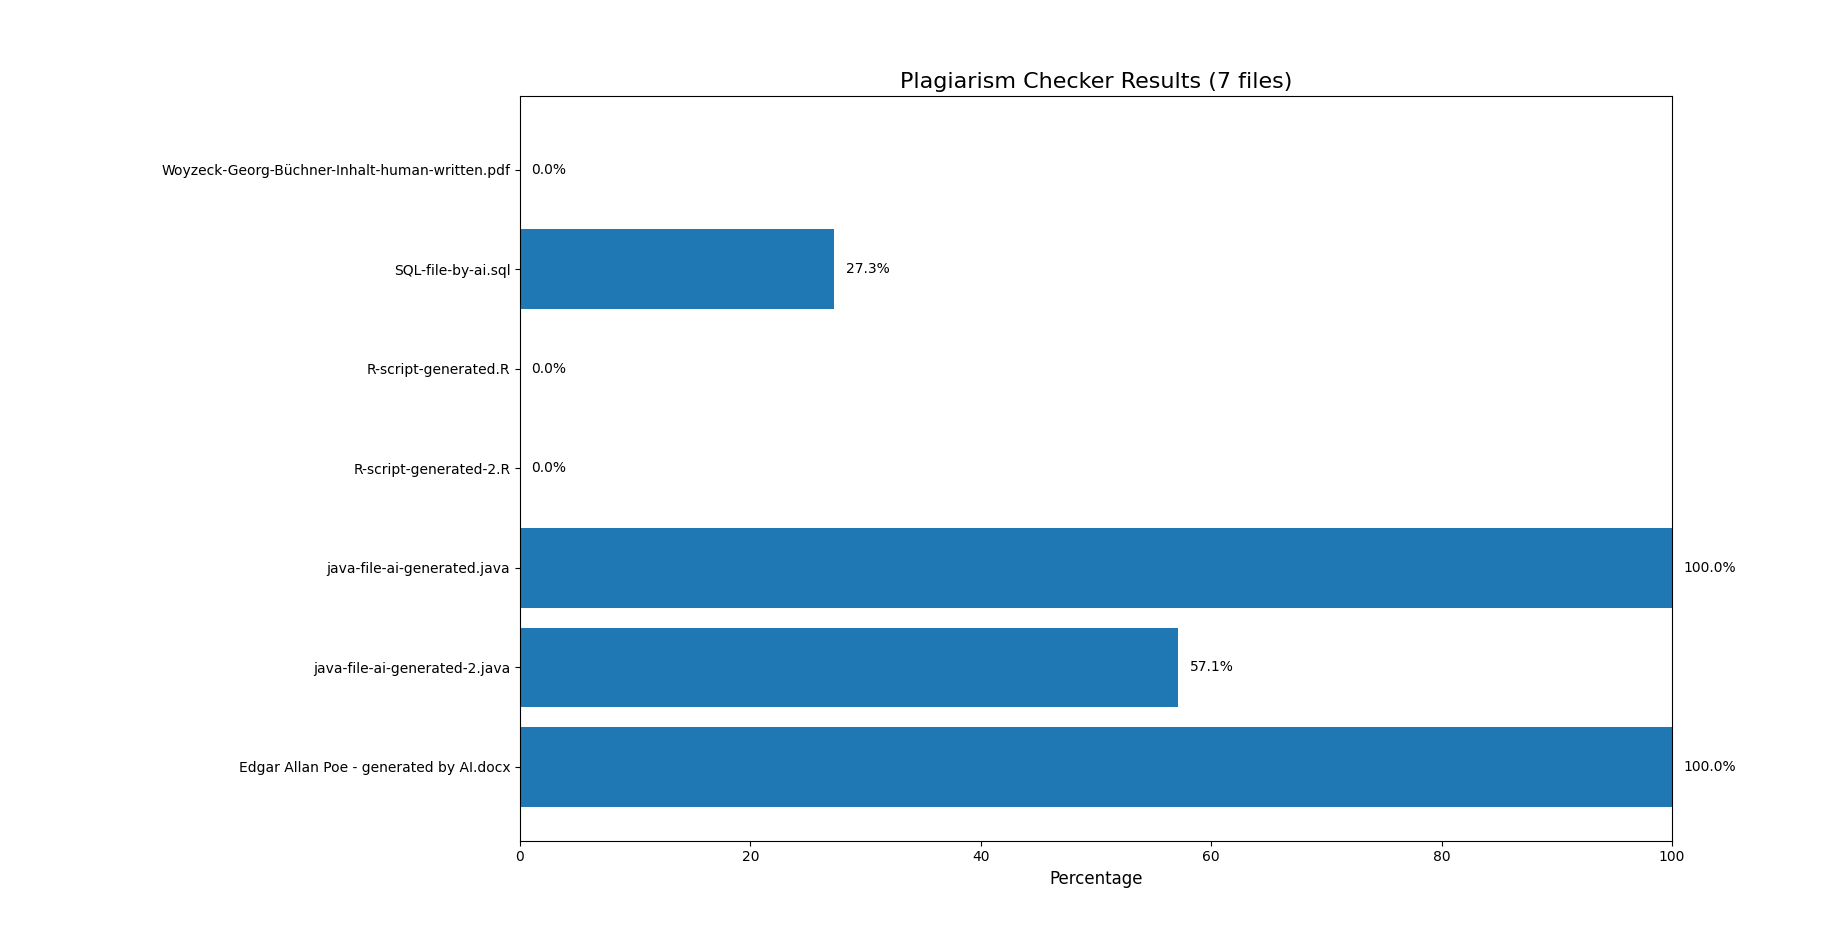
Just in time Plagiats Check für die HÜ-Abgabe mittels eines vortrainierten AI-Services
Mit Mitteln eines vortrainierten AI-Services (ChatGPT) können Abgaben auf Pagiatsverdacht überprüft werden. Hier geht es vor allem darum, die praktische Einsatzmöglichkeit von AI in Kombination […]

Recommendersysteme wie bei TikTok, Instgram, Amazon und Netflix
Statistische Ähnlichkeit und ML Erhöhung der Probability of Choice durch gezielte Recommendations im Webshop oder Kontaktempfehlungen bei LinkedIn – all diese Funktionalität wird durch statistische […]
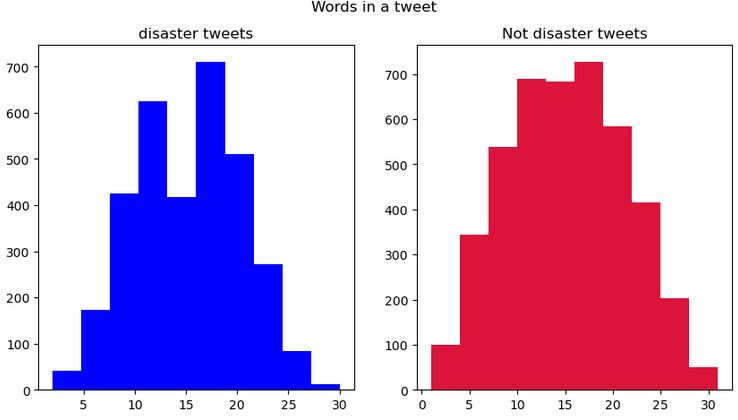
NLP with Disaster Tweets
Ziel des Projekts/Unterrichts ist es, natürliche Sprache in Texten, Blogs, Kommentaren, etc mittels Methoden des NLP (Natural Language Processing) zu verarbeiten.
Im Speziellen sollen dabei Twitter Messages (Tweets) darauf untersucht werden, ob das Vorkommen bestimmter „Katastrophenwörter“ (disaster terms) auf ein reales Ereignis zutreffen oder nur methaphorisch verwendet werden.
Dazu werden rund 10000 Trainingsdaten von Twitter-Einträgen verwendet, die per Hand klassifiziert wurden