Große Sprachmodelle (LLMs) formulieren hervorragend – aber sie kennen unsere Daten nicht. Fragt man ein LLM, wie sich der Preis von Tiefkühlpizza im Dezember 2023 in Österreich entwickelt hat, bekommt man bestenfalls eine Schätzung, schlimmstenfalls eine erfundene Zahl. Retrieval-Augmented Generation (RAG) löst dieses Problem: Bevor das LLM antwortet, suchen wir die passenden Fakten aus einer eigenen Datenbank und geben sie dem Modell als Kontext mit.
In diesem Artikel bauen wir ein komplettes, lokal laufendes RAG-System am Beispiel des österreichischen Verbraucherpreisindex (VPI) – Schritt für Schritt, jeweils für Linux (Ubuntu) und OSX und sogar Windows (naja, WSL).
Alles läuft lokal, kein Cloud-Dienst, keine API-Keys: Alles läuft auf dem eigenen Rechner… der hoffentlich viel Speicher für seine GPU hat 😉
Inhalt
- Was ist RAG?
- Embeddings oder Trigramme? RAG vs.
pg_trgm - Das VPI-Beispiel
- Schritt 1: PostgreSQL installieren
- Schritt 2: pgvector installieren
- Schritt 3: Rolle
raguserund Datenbankvpianlegen - Schritt 4: Python-Umgebung einrichten
- Schritt 5: Embedding-Modell laden
- Schritt 6: Ollama und Qwen 3 installieren
- Schritt 7: Zugangsdaten in
.enveintragen - Schritt 8: CSV → Texte
- Schritt 9: Texte → Vektoren
- Schritt 10: Vektoren → PostgreSQL/pgvector
- Schritt 11: Die RAG-Abfrage
- Gesamttest: alles auf einmal
- Windows: das Ganze mit WSL 2
- W1: WSL 2 und Ubuntu 26.04 installieren
- W2: systemd aktivieren und
.wslconfiganlegen - W3: PostgreSQL 18 und pgvector in WSL
- W4: Zugriff von Windows – pgAdmin,
listen_addressesundpg_hba.conf - W5: Python-Umgebung und Projektdateien
- W6: Ollama – in WSL (empfohlen) oder als Windows-App
- W7: Pipeline ausführen und Gesamttest
- Fehlerbehebung
- Fazit
Was ist RAG?
RAG besteht aus drei Teilen:
- Retrieval – Die Frage wird in einen Vektor (Embedding) umgewandelt. In einer Vektordatenbank werden die inhaltlich ähnlichsten Textstücke gesucht.
- Augmented – Diese Textstücke werden zusammen mit der Frage in den Prompt geschrieben.
- Generation – Das LLM formuliert die Antwort ausschließlich auf Basis dieser Quellen.
Der Trick: Ähnliche Texte haben ähnliche Vektoren. Ein Embedding-Modell übersetzt Sätze in Zahlenreihen (bei uns 384 Zahlen), und die Kosinus-Distanz zwischen zwei Vektoren misst, wie ähnlich die Bedeutung ist. PostgreSQL kann mit der Erweiterung pgvector genau solche Vektoren speichern und blitzschnell durchsuchen.
Embeddings oder Trigramme? RAG vs. pg_trgm
PostgreSQL kann mit der Extension pg_trgm schon lange unscharf suchen. Dabei wird Text in Dreiergruppen von Buchstaben zerlegt – aus „hof“ wird {" h"," ho",hof,"of "}. Die Ähnlichkeit zweier Texte ist der Anteil gemeinsamer Trigramme. Wozu dann Embeddings?
Im RAG-Kontext sind Trigramme genau der Teil, den Embeddings nicht gut ersetzen:
- Tippfehler, Eigennamen, Produktcodes, ISINs, Teilstrings: Hier sind Trigramme stark, Embeddings oft schwach.
- Synonyme und Umschreibungen („Kfz“ und „Fahrzeug“): Hier sind Embeddings stark, Trigramme nutzlos.
Beispiel: die Schulordnung
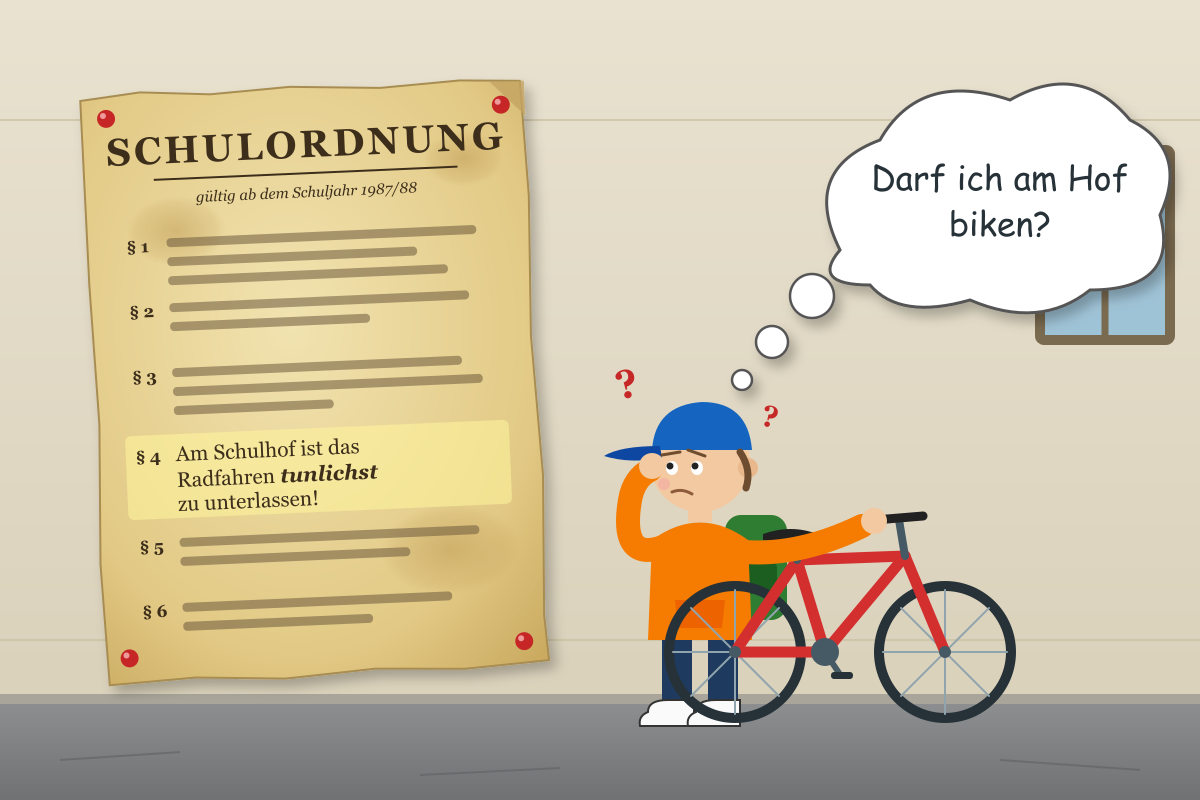
In der Schulordnung steht:
Am Schulhof ist das Radfahren tunlichst zu unterlassen!
Ein Schüler fragt: „darf ich am hof biken?“ Für einen Menschen ist sofort klar, dass die Regel die Antwort ist. Die Frage teilt mit ihr aber kaum Buchstabenfolgen: „biken“ ≠ „Radfahren“, „hof“ ist nur ein Teil von „Schulhof“.
Trigramme (direkt in psql):
CREATE EXTENSION IF NOT EXISTS pg_trgm;

SELECT similarity('Am Schulhof ist das Radfahren tunlichst zu unterlassen!',
                  'darf ich am hof biken?');          -- 0.154

SELECT similarity('Am Schulhof ist das Radfahren tunlichst zu unterlassen!',
                  'Die Mensa öffnet um 11 Uhr.');     -- 0.026
Embeddings (Python):
Voraussetzung: Für diesen Teil braucht man Python mit dem Paket sentence-transformers. Beides richten wir erst in Schritt 4 ein. Wer selbst nachrechnen will, kommt also nach Schritt 5 hierher zurück – zum Verstehen genügt die Tabelle weiter unten.
from sentence_transformers import SentenceTransformer, util

regel = "Am Schulhof ist das Radfahren tunlichst zu unterlassen!"
for modell in ["all-MiniLM-L6-v2", "paraphrase-multilingual-MiniLM-L12-v2"]:
    m = SentenceTransformer(modell)
    for text in ["darf ich am hof biken?", "Die Mensa öffnet um 11 Uhr."]:
        a, b = m.encode([regel, text])
        print(modell, text, round(float(util.cos_sim(a, b)), 3))
Was macht dieser Code?
SentenceTransformer(modell)lädt ein Embedding-Modell. Beim ersten Aufruf wird es von Hugging Face heruntergeladen, danach liegt es lokal im Cache.m.encode([regel, text])wandelt die beiden Sätze in je einen Vektor aus 384 Zahlen um – das Embedding.util.cos_sim(a, b)berechnet die Kosinus-Ähnlichkeit der beiden Vektoren: Werte nahe 1 bedeuten „gleiche Bedeutung“, Werte nahe 0 „nichts miteinander zu tun“.- Die beiden Schleifen wiederholen das für zwei Modelle und zwei Vergleichssätze: die passende Frage und einen unpassenden Satz über die Mensa.
Die gemessenen Ähnlichkeiten (0 = nichts gemeinsam, 1 = identisch):
| Vergleich | pg_trgm | all-MiniLM-L6-v2 | paraphrase-multilingual-MiniLM-L12-v2 |
|---|---|---|---|
| Regel ↔ „darf ich am hof biken?“ | 0.154 | 0.436 | 0.563 |
| Regel ↔ „Die Mensa öffnet um 11 Uhr.“ (unpassend) | 0.026 | 0.309 | 0.099 |
AT0000A0E9W5 ↔ AT0000A0E9W6 (zwei verschiedene ISINs) | 0.714 | 0.969 | 0.994 |
Was die Zahlen zeigen:
- Umschreibung: Für Trigramme ist die Frage kaum ähnlicher als ein Satz über die Mensa (nur „am“ und „hof“ überlappen). Das Embedding erkennt dagegen „biken“ ≈ „Radfahren“ und „hof“ ≈ „Schulhof“. Beim mehrsprachigen Modell ist der Abstand zum unpassenden Satz deutlich (0.563 vs. 0.099). Das englisch trainierte
all-MiniLM-L6-v2trennt bei deutschen Alltagssätzen schwächer (0.436 vs. 0.309). Für deutsche Freitexte lohnt sich daher ein mehrsprachiges Modell. In unserem VPI-Beispiel funktioniert das kleine Modell gut, weil alle Texte nach demselben Muster gebaut sind. - Codes: Für Embeddings sind zwei ISINs, die sich in einem Zeichen unterscheiden, praktisch identisch (0.99). Es sind aber zwei verschiedene Wertpapiere. Bei Kennungen ist nur der exakte Treffer richtig. Den liefern ein Vergleich mit
=oderLIKEoder ein Trigramm-Index, bei dem der exakte Treffer mit 1.0 ganz oben steht.
all-MiniLM-L6-v2 oder paraphrase-multilingual-MiniLM-L12-v2?
Beide Modelle stammen aus der Bibliothek Sentence Transformers und liefern Vektoren mit 384 Dimensionen. Sie unterscheiden sich darin, womit sie trainiert wurden und wie groß sie sind:
all-MiniLM-L6-v2 | paraphrase-multilingual-MiniLM-L12-v2 | |
|---|---|---|
| Sprachen | Englisch | über 50 Sprachen, darunter Deutsch |
| Trainingsdaten | über 1 Milliarde englische Satzpaare | Paraphrasen; ein englisches Lehrer-Modell wurde mit übersetzten Satzpaaren auf andere Sprachen übertragen |
| Transformer-Schichten | 6 (das „L6“ im Namen) | 12 (das „L12“ im Namen) |
| Parameter | ca. 23 Millionen | ca. 118 Millionen |
| Größe auf der Platte | ca. 90 MB | ca. 470 MB |
| Wortschatz (Tokens) | ca. 30.000, englisch | ca. 250.000, mehrsprachig |
| Maximale Textlänge | 256 Tokens | 128 Tokens |
| Vektorlänge | 384 | 384 |
Den Unterschied sieht man schon daran, wie die Modelle deutsche Wörter in Tokens zerlegen. Das englische Modell kennt „Radfahren“ nicht und zerhackt es in sinnlose Stücke, das mehrsprachige erkennt die Wortteile:
| Wort | all-MiniLM-L6-v2 | paraphrase-multilingual-MiniLM-L12-v2 |
|---|---|---|
| Radfahren | ra · df · ah · ren | Rad · fahren |
| Schulhof | sc · hul · hof | Schul · hof |
| biken | bike · n | bike · n |
Faustregel: Für englische Texte oder sehr gleichförmige Texte ist das kleine Modell die schnellere Wahl. Für deutsche Freitexte – Schulordnungen, E-Mails, Fragen in Alltagssprache – ist das mehrsprachige Modell deutlich treffsicherer. Es braucht dafür rund fünfmal so viel Speicher, rechnet langsamer und verarbeitet nur halb so lange Textstücke.
Weil beide Modelle 384 Dimensionen liefern, passt die Tabellenspalte vector(384) für beide. Mischen darf man sie trotzdem nicht: Vektoren verschiedener Modelle sind nicht vergleichbar. Wer das Modell wechselt, muss alle Texte neu einbetten (Skript 02 und 03) und auch die Fragen mit dem neuen Modell kodieren (Skript 07).
In der Praxis kombiniert man deshalb beides zur hybriden Suche: Embeddings für die Bedeutung, Trigramme bzw. exakte Filter für Namen, Codes und Tippfehler. Unser Abfrageskript macht das bereits mit dem Datumsfilter (siehe Schritt 11). Ein Trigramm-Index auf die Texte wäre die nächste Ausbaustufe: CREATE INDEX ON vpi_embeddings USING gin (text gin_trgm_ops);
Das VPI-Beispiel
Datengrundlage ist alle_produkte.csv: 91 Produkte × 36 Monate (Jänner 2023 bis Dezember 2025) mit Min-/Max-/Median-Preisen sowie den Indizes VPI (Gesamt und Nahrungsmittel), Importpreisindex (IMPI) und Erzeugerpreisindex (EPI). Aus jeder Zeile erzeugen wir einen deutschen Beschreibungstext, zum Beispiel:
Woher die Daten kommen: vom Preisradar der Statistik Austria. Das Skript webscraping.py holt für jedes Produkt die Zeitreihen aus den JSON-Endpunkten des Preisradars (…/preisradar/data/ep/<productId>.json). Daraus entsteht pro Produkt eine Einzeldatei csv_output/<productId>_unified.csv mit Preisen und den jeweils verfügbaren Indizes (VPI des Produkts, der Unter- und der Produktgruppe, Gesamtindex, Import-, Erzeuger-, Großhandels- und Agrarpreisindex). Welche Indizes es gibt, ist je Produkt verschieden – csv_output/merge.py bildet sie deshalb auf einheitliche Spalten ab und fügt alle 91 Einzeldateien zu alle_produkte.csv zusammen.
Pizza, tiefgekühlt (330 Gramm) kostete im März 2024 im Median 2.76 € (Spanne: 1.67 – 3.36 €). Gegenüber dem Vormonat entspricht das einem leichten Anstieg von +0.8%. Der VPI-Gesamtindex liegt bei 123.7 (+0.49% ggü. Vormonat), der Index der Produktgruppe (VPI 0111) bei 128.5 (+0.31% ggü. Vormonat). Die Preisentwicklung liegt im Einklang mit der allgemeinen Inflation. Lieferkette: Der Importpreisindex blieb stabil (+0.00%), der Erzeugerpreisindex blieb stabil (+0.49%).
Diese 3.276 Texte werden zu Vektoren, landen in PostgreSQL/pgvector und werden bei jeder Frage durchsucht. Die Pipeline:
csv_output/<productId>_unified.csv   (91 Einzeldateien vom Preisradar)
    │  merge.py
    ▼
alle_produkte.csv
    │  01_csv_zu_text.py          (Regeln → deutscher Text pro Produkt & Monat)
    ▼
texte.csv
    │  02_text_zu_vektoren.py     (all-MiniLM-L6-v2 → 384-dim. Embeddings)
    ▼
vektoren.pkl
    │  03_vektoren_nach_pgvector.py
    ▼
PostgreSQL + pgvector  (Tabelle vpi_embeddings, Rolle raguser)
    ▲
    │  07_rag_abfrage.py
Frage → Embedding → Datumsfilter + Kosinus-Suche (Top 7) → Qwen 3 (Ollama) → Antwort
| Komponente | Werkzeug |
|---|---|
| Vektordatenbank | PostgreSQL 18 + pgvector |
| Embedding-Modell | all-MiniLM-L6-v2 (sentence-transformers, 384 Dimensionen) |
| LLM | Qwen 3 8B, lokal über Ollama (als vpi-qwen) |
| Programmiersprache | Python 3 (pandas, psycopg2, openai-Client) |
Schritt 1: PostgreSQL installieren
Wir verwenden PostgreSQL 18 aus den offiziellen Quellen von postgresql.org.
Ubuntu
Wir nehmen das offizielle APT-Repository von postgresql.org (Anleitung), weil die Ubuntu-Pakete oft älter sind:
sudo apt update
sudo apt install -y postgresql-common
sudo /usr/share/postgresql-common/pgdg/apt.postgresql.org.sh   # richtet apt.postgresql.org ein
sudo apt install -y postgresql-18
✅ Test:
pg_lsclusters
sudo -u postgres psql -c "SELECT version();"
Erwartet: 18 main 5432 online … bzw. PostgreSQL 18.x on x86_64-pc-linux-gnu …
macOS
Auf dem Mac installieren wir über Homebrew (brew.sh; weitere Varianten: postgresql.org/download/macosx):
brew install postgresql@18
brew services start postgresql@18

# postgresql@18 ist "keg-only" → Pfad setzen (Apple Silicon und Intel)
echo 'export PATH="$(brew --prefix)/opt/postgresql@18/bin:$PATH"' >> ~/.zshrc
source ~/.zshrc
Hinweis: Unter Homebrew heißt der Superuser wie dein macOS-Benutzer, nicht postgres.
✅ Test:
brew services list | grep postgresql
psql postgres -c "SELECT version();"
Erwartet: postgresql@18 started bzw. PostgreSQL 18.x on aarch64-apple-darwin …
Windows (WSL 2)
Unter Windows läuft alles in Ubuntu unter WSL 2. Der Befehl heißt wsl, nicht wsl2. PowerShell als Administrator:
wsl --update
wsl --install -d Ubuntu-26.04
Beim ersten Start legt Ubuntu einen Linux-Benutzer an. Ab dann gilt in jedem Schritt die Ubuntu-Variante.
✅ Test:
# PowerShell
wsl --version
wsl -l -v
# in WSL (Ubuntu)
lsb_release -ds
pg_lsclusters
sudo -u postgres psql -c "SELECT version();"
Erwartet: Ubuntu-26.04 mit VERSION 2, Ubuntu 26.04 LTS, 18 main 5432 online und PostgreSQL 18.x on x86_64-pc-linux-gnu.
Alles Weitere zu Windows – systemd, Speicher, pgAdmin, listen_addresses, pg_hba.conf – steht im Kapitel Windows: das Ganze mit WSL 2.
Schritt 2: pgvector installieren
pgvector bringt den Datentyp vector und die Abstandsoperatoren <-> (euklidisch), <#> (Skalarprodukt) und <=> (Kosinus).
Ubuntu
Das Paket kommt aus dem Repository von Schritt 1:
sudo apt install -y postgresql-18-pgvector
✅ Test:
sudo -u postgres psql -c "SELECT name, default_version FROM pg_available_extensions WHERE name = 'vector';"
Erwartet: eine Zeile vector | 0.8.7
macOS
brew install pgvector
brew services restart postgresql@18
✅ Test:
psql postgres -c "SELECT name, default_version FROM pg_available_extensions WHERE name = 'vector';"
Erwartet: eine Zeile vector | 0.8.7
Schritt 3: Rolle raguser und Datenbank vpi anlegen
Die Skripte sollen nicht als Superuser laufen. Sie bekommen eine eigene Rolle raguser, der die Datenbank vpi gehört. Nur die Extension vector muss einmal ein Superuser anlegen.
Superuser-Shell öffnen:
# Ubuntu
sudo -u postgres psql

# macOS (Homebrew)
psql postgres
Dann in psql (Passwort anpassen):
CREATE ROLE raguser WITH LOGIN PASSWORD 'rag123';
CREATE DATABASE vpi OWNER raguser;

\c vpi
CREATE EXTENSION IF NOT EXISTS vector;
\dx
\q
Seit PostgreSQL 15 gehört das Schema public dem Datenbank-Eigentümer. raguser darf dort Tabellen anlegen, ohne weitere GRANTs.
✅ Test:
# 1) Login als raguser über TCP (so verbinden sich auch die Python-Skripte)
psql "postgresql://raguser:rag123@localhost:5432/vpi" -c "SELECT current_user, current_database();"

# 2) Vektor-Rechnung: Kosinus-Distanz zweier Vektoren
psql "postgresql://raguser:rag123@localhost:5432/vpi" -c "SELECT '[1,2,3]'::vector <=> '[1,2,4]'::vector AS kosinus_distanz;"

# 3) Darf raguser Tabellen mit Vektor-Spalte anlegen?
psql "postgresql://raguser:rag123@localhost:5432/vpi" -c "CREATE TABLE t_test (v vector(3)); DROP TABLE t_test;"
Erwartet: raguser | vpi, Distanz ca. 0.0085, CREATE TABLE und DROP TABLE ohne Fehler.
Schritt 4: Python-Umgebung einrichten
Ubuntu
sudo apt install -y python3 python3-venv python3-pip
macOS
brew install python@3.12
Beide Systeme
Projektordner anlegen und die Workshop-Dateien hineinkopieren. Die Skripte gibt es hier als Download: vpi_workshop_skripte.zip (01–07, webscraping.py, csv_output/merge.py, Modelfile, .env.example). Dazu kommen die Datendateien csv_output/<productId>_unified.csv vom Preisradar-Export. Dann:
mkdir -p ~/vpi_workshop/csv_output
cd ~/vpi_workshop
python3 -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install pandas sentence-transformers psycopg2-binary openai python-dotenv
✅ Test:
python3 --version
python3 -c "import pandas, psycopg2, openai, torch; print('Pakete OK, torch', torch.__version__)"
python3 -c "import psycopg2; c = psycopg2.connect('postgresql://raguser:rag123@localhost:5432/vpi'); print('DB OK'); c.close()"
Erwartet: Python ≥ 3.10, Pakete OK, torch 2.x und DB OK.
Schritt 5: Embedding-Modell laden
all-MiniLM-L6-v2 ist klein (ca. 90 MB), läuft schnell auf der CPU und liefert Vektoren mit 384 Dimensionen. Beim ersten Aufruf wird es automatisch heruntergeladen.
✅ Test:
# Python starten
python3
Dann am Python-Prompt (>>>) einfügen:
from sentence_transformers import SentenceTransformer, util
m = SentenceTransformer('all-MiniLM-L6-v2')
a, b, c = m.encode(['Der Preis von Butter stieg stark', 'Butter wurde deutlich teurer', 'Das Wetter ist schön'])
print('Dimension:', len(a))
print('Butter/Butter :', round(float(util.cos_sim(a, b)), 3))
print('Butter/Wetter :', round(float(util.cos_sim(a, c)), 3))

exit()
Erwartet: Dimension: 384. Die beiden Butter-Sätze sind einander deutlich ähnlicher als Butter und Wetter.
Schritt 6: Ollama und Qwen 3 installieren
Ollama führt LLMs lokal aus und bietet eine OpenAI-kompatible API unter http://localhost:11434/v1. Qwen 3 8B braucht ca. 8 GB freien RAM.
Ubuntu
curl -fsSL https://ollama.com/install.sh | sh # richtet auch einen systemd-Dienst ein
✅ Test:
systemctl status ollama --no-pager
Erwartet: active (running)
macOS
brew install ollama
brew services start ollama
# alternativ: App von https://ollama.com/download installieren und starten
✅ Test:
brew services list | grep ollama
Erwartet: ollama started
Beide Systeme: Modell laden und eigenes Profil anlegen
Das Modelfile legt eine niedrige Temperatur, die Kontextgröße (num_ctx) und einen System-Prompt fest. num_ctx 8192 ist wichtig: Sieben deutsche Quellen plus Frage passen sonst auf Rechnern mit wenig RAM nicht in den Standard-Kontext.
FROM qwen3:8b

PARAMETER temperature 0.1
PARAMETER top_p 0.9
PARAMETER top_k 20
PARAMETER num_ctx 8192

SYSTEM """Du bist ein Datenanalyst für Konsumentenpreise in Österreich.
Antworte kurz, faktisch und mit konkreten Zahlen."""
ollama pull qwen3:8b                         # ca. 5 GB
cd ~/vpi_workshop
ollama create vpi-qwen -f Modelfile
✅ Test:
ollama list
ollama run vpi-qwen "Antworte mit einem Wort: Wie heißt die Hauptstadt von Österreich?"
curl -s http://localhost:11434/v1/models
Erwartet: vpi-qwen und qwen3:8b in der Liste, die Antwort Wien (evtl. mit <think>-Block davor), JSON mit beiden Modellen.
Schritt 7: Zugangsdaten in .env eintragen
Die Skripte 02, 03 und 07 lesen Datenbank, Ollama-Adresse und Modellnamen aus der Datei .env im Projektordner (per python-dotenv). Zugangsdaten stehen so an einer Stelle und nicht im Code:
cd ~/vpi_workshop
cp .env.example .env
nano .env        # Passwort anpassen, falls in Schritt 3 ein anderes gewählt wurde
Inhalt von .env:
DB_URL=postgresql://raguser:rag123@localhost:5432/vpi
OLLAMA_URL=http://localhost:11434/v1
LLM_MODELL=vpi-qwen
EMBED_MODEL=all-MiniLM-L6-v2
Fehlt die Datei, verwenden die Skripte genau diese Werte als Standard. EMBED_MODEL muss in Skript 02 (Texte einbetten) und 07 (Fragen einbetten) dasselbe sein – deshalb steht es nur hier.
✅ Test:
python3 -c "from dotenv import load_dotenv; import os; load_dotenv(); print(os.getenv('DB_URL'))"
psql "$(grep ^DB_URL .env | cut -d= -f2-)" -c "SELECT current_user;"
Erwartet: postgresql://raguser:rag123@localhost:5432/vpi und raguser.
Schritt 8: CSV → Texte
Zuerst die 91 Einzeldateien zu alle_produkte.csv zusammenführen:
cd ~/vpi_workshop/csv_output && source ../venv/bin/activate
python merge.py
cd ..
✅ Test:
wc -l csv_output/alle_produkte.csv
head -1 csv_output/alle_produkte.csv
Erwartet: 91 Einzeldateien → alle_produkte.csv: 3276 Zeilen, 91 Produkte, dann 3277 Zeilen und eine Kopfzeile mit den Spalten VPI_produkt … IMPI, EPI_PB, GHPI, API samt *_code.
01_csv_zu_text.py liest die CSV ein, berechnet die Preisänderung zum Vormonat und formuliert daraus deutsche Sätze (z. B. „Δ > +5 % → starker Anstieg“).
cd ~/vpi_workshop && source venv/bin/activate
python 01_csv_zu_text.py
✅ Test:
wc -l csv_output/texte.csv
head -c 600 csv_output/texte.csv
Erwartet: 3277 Zeilen (3.276 Texte + Kopfzeile) und lesbare deutsche Sätze.
Schritt 9: Texte → Vektoren
python 02_text_zu_vektoren.py # ca. 30 Sekunden
✅ Test:
# Python starten
python3
Dann am Python-Prompt (>>>) einfügen:
import pickle
df = pickle.load(open('csv_output/vektoren.pkl', 'rb'))
print(len(df), 'Einträge, Dimension', df['embedding'].iloc[0].shape)

exit()
Erwartet: 3276 Einträge, Dimension (384,)
Schritt 10: Vektoren → PostgreSQL/pgvector
03_vektoren_nach_pgvector.py legt die Tabelle vpi_embeddings mit der Spalte embedding vector(384) und einem IVFFlat-Index an und importiert alle Einträge.
python 03_vektoren_nach_pgvector.py
Der Index wurde auf der leeren Tabelle angelegt. Nach dem Import bauen wir ihn einmal neu:
psql "postgresql://raguser:rag123@localhost:5432/vpi" -c "REINDEX INDEX vpi_embeddings_embedding_idx;"
✅ Test:
psql "postgresql://raguser:rag123@localhost:5432/vpi"
Dann am psql-Prompt (vpi=>) einfügen:
-- Anzahl der Zeilen
SELECT count(*) FROM vpi_embeddings;

-- Semantische Suche direkt in SQL: die 5 nächsten Nachbarn von Eintrag 1
SELECT product_id, date,
       round((1 - (embedding <=> (SELECT embedding FROM vpi_embeddings WHERE id = 1)))::numeric, 3) AS aehnlichkeit
FROM vpi_embeddings
ORDER BY embedding <=> (SELECT embedding FROM vpi_embeddings WHERE id = 1)
LIMIT 5;

\q
Erwartet: 3276 Zeilen. In der zweiten Abfrage steht Eintrag 1 mit Ähnlichkeit 1.000 ganz oben.
Achtung: Jeder Lauf des Skripts fügt alle Zeilen erneut ein. Vor einem zweiten Lauf: psql "postgresql://raguser:rag123@localhost:5432/vpi" -c "TRUNCATE vpi_embeddings;"
Schritt 11: Die RAG-Abfrage
07_rag_abfrage.py verbindet alles. Bei jeder Frage:
- erkennt es per Regex ein Datum („Dezember 2023“, „im Jahr 2024“, „2023-12“, auch „Jänner“) und filtert die Tabelle vorab danach (hybride Suche: SQL-Filter + Vektorsuche),
- wandelt die Frage mit demselben Embedding-Modell in einen Vektor um,
- holt mit
ORDER BY embedding <=> frage_vektor LIMIT 7die sieben ähnlichsten Texte, - schreibt diese als nummerierte Quellen in den Prompt und lässt
vpi-qwenantworten – mit der Anweisung, sich ausschließlich auf die Quellen zu stützen.
Beim ersten Start wandelt das Skript die Spalte date von TEXT in DATE um und legt einen Datumsindex an.
Qwen 3 „denkt“ vor jeder Antwort in einem <think>-Block, bei einer einfachen Frage mehrere hundert Tokens. Für RAG bringt das nichts, kostet aber Zeit. Das Skript schaltet es deshalb beim Aufruf ab:
response = client.chat.completions.create(
    model=LLM_MODELL,
    messages=[...],
    temperature=0.2,
    extra_body={"reasoning_effort": "none"},  # Qwen 3 ohne <think>-Block (schneller)
)
Gemessen auf einem Mac: 3 statt 118 Ausgabe-Tokens für eine Ein-Wort-Antwort. Im Modelfile lässt sich das nicht einstellen – PARAMETER think false lehnt Ollama ab, und /no_think im System-Prompt wirkt unter Ollama nicht. Der System-Prompt aus dem Modelfile gilt übrigens nur bei ollama run; das Skript schickt seinen eigenen, und der ersetzt ihn.
python 07_rag_abfrage.py "Welches Produkt hatte im Dezember 2023 den höchsten Preisanstieg?"

# interaktiver Modus (Beenden mit exit)
python 07_rag_abfrage.py
✅ Test:
psql "postgresql://raguser:rag123@localhost:5432/vpi" -c "\d vpi_embeddings"
Erwartet: Erkanntes Datum: Dezember 2023, sieben Treffer aus 2023-12 und eine deutsche Antwort mit Produkten und Prozentzahlen. \d vpi_embeddings zeigt für date den Typ date.
Weitere Fragen zum Ausprobieren:
- Wie hat sich der Butterpreis im Jahr 2024 entwickelt?
- Bei welchen Produkten ist der Importpreisanstieg noch nicht im Konsumentenpreis angekommen?
- Welche Produkte wurden im Jänner 2025 billiger?
Gesamttest: alles auf einmal
cd ~/vpi_workshop && source venv/bin/activate
# Python starten
python3
Dann am Python-Prompt (>>>) einfügen:
import psycopg2
from sentence_transformers import SentenceTransformer
from openai import OpenAI

m = SentenceTransformer('all-MiniLM-L6-v2')
print('[1/3] Embedding: dim =', m.encode('Test').shape[0])

conn = psycopg2.connect('postgresql://raguser:rag123@localhost:5432/vpi')
cur = conn.cursor()
cur.execute('SELECT count(*) FROM vpi_embeddings')
print('[2/3] pgvector: Zeilen =', cur.fetchone()[0])
conn.close()

client = OpenAI(base_url='http://localhost:11434/v1', api_key='x')
r = client.chat.completions.create(model='vpi-qwen', messages=[{'role': 'user', 'content': 'Sag OK'}])
print('[3/3] Ollama: OK')
print('ALLES BEREIT!')

exit()
Windows: das Ganze mit WSL 2
Unter Windows läuft das System nicht nativ, sondern im Windows-Subsystem für Linux (WSL 2): einer kleinen Linux-VM mit echtem Ubuntu 26.04. Darin funktionieren Schritt 1–11 (Ubuntu) unverändert. Dieses Kapitel beschreibt nur, was unter Windows zusätzlich zu tun ist – vor allem den Zugriff von Windows aus, etwa mit pgAdmin.
Empfohlener Weg (den wir hier durchgehend verwenden):
- Alles in WSL: PostgreSQL 18 + pgvector, Python-venv, Ollama und die Skripte laufen in Ubuntu 26.04 unter WSL 2. Die Skripte verbinden sich wie unter Linux mit
localhost:5432undlocalhost:11434– kein Code ändert sich. - Windows 11 (22H2 oder neuer): Netzwerkmodus
mirrored. Windows und WSL teilen sich dann127.0.0.1; pgAdmin unter Windows erreicht PostgreSQL in WSL über127.0.0.1:5432. - Windows 10 (oder Windows 11 ohne Mirrored-Modus): Standardmodus
NATmit localhost-Forwarding – funktioniert für pgAdmin in aller Regel ebenfalls über127.0.0.1:5432. - An der PostgreSQL-Konfiguration ändern wir im Normalfall nichts:
listen_addresses = 'localhost'und die Standard-pg_hba.confreichen. Erst wenn man über die WSL-IP-Adresse verbinden muss, sind Änderungen nötig (siehe W4). - Das Projekt liegt im Linux-Dateisystem unter
~/vpi_workshop, nicht unter/mnt/c/….
Jeder Codeblock sagt im ersten Kommentar, wo er läuft: # PowerShell (Windows) oder # in WSL (Ubuntu).
W1: WSL 2 und Ubuntu 26.04 installieren
Voraussetzung: Windows 10 ab Version 2004 oder Windows 11, Virtualisierung im BIOS/UEFI aktiv. PowerShell als Administrator:
# PowerShell (als Administrator)
# WSL selbst auf den aktuellen Stand bringen
wsl --update

# Ubuntu 26.04 LTS installieren (verfügbare Namen: wsl --list --online)
wsl --install -d Ubuntu-26.04
# danach Windows neu starten, falls verlangt
Nach dem Neustart fragt Ubuntu nach einem Linux-Benutzernamen und Passwort; das Passwort braucht man später für sudo. Gibt es schon eine WSL-1-Distribution: vorher wsl --set-default-version 2.
✅ Test:
# PowerShell
wsl --version
wsl -l -v
Erwartet: WSL-Version 2.x und Ubuntu-26.04 mit VERSION 2. Fehlt wsl --version: wsl --update. Steht dort VERSION 1: wsl --set-version Ubuntu-26.04 2.
W2: systemd aktivieren und .wslconfig anlegen
systemd: Die Ubuntu-Schritte verwenden systemctl. Dafür muss in WSL systemd laufen. Prüfen:
# in WSL (Ubuntu)
cat /etc/wsl.conf
Fehlt der Abschnitt, ergänzen wir ihn:
# in WSL (Ubuntu)
sudo tee -a /etc/wsl.conf > /dev/null <<'EOF'
[boot]
systemd=true
EOF
Speicher und Netzwerkmodus: Die Einstellungen der WSL-VM stehen in %UserProfile%\.wslconfig (anfangs nicht vorhanden). Standardmäßig bekommt WSL die Hälfte des RAMs. Für Qwen 3 8B empfehlen wir memory=10GB bei 16 GB RAM und memory=16GB ab 32 GB.
networkingMode=mirrored gibt es erst ab Windows 11 22H2. Unter Windows 10 die Zeile weglassen, dann gilt NAT.
# PowerShell (als normaler Benutzer) – öffnet bzw. erzeugt die Datei im Editor
notepad "$env:USERPROFILE\.wslconfig"
# Inhalt von %UserProfile%\.wslconfig
[wsl2]
memory=10GB
# nur Windows 11 22H2+; unter Windows 10 diese Zeile weglassen
networkingMode=mirrored
Die Datei muss .wslconfig heißen, nicht .wslconfig.txt (in Notepad „Alle Dateien“ wählen). Alternativ setzt die App „WSL Settings“ dieselben Werte.
Die Änderungen gelten erst nach einem Neustart der WSL-VM:
# PowerShell
wsl --shutdown
# ca. 8 Sekunden warten, dann Ubuntu wieder öffnen
wsl -d Ubuntu-26.04
✅ Test:
# in WSL (Ubuntu)
ps -p 1 -o comm=           # welcher Prozess ist PID 1?
systemctl is-system-running
free -h                    # Gesamtspeicher der WSL-VM
wslinfo --networking-mode  # nur bei neueren WSL-Versionen vorhanden
Erwartet: systemd als PID 1, running (oder degraded – in WSL meist harmlos), bei free -h etwa der eingestellte Speicher, bei wslinfo mirrored bzw. nat. Fehlt wslinfo: Im Mirrored-Modus zeigt ip addr dieselben Adressen wie ipconfig unter Windows.
W3: PostgreSQL 18 und pgvector in WSL
Hier gibt es nichts Windows-Spezifisches: Schritt 1–3 (Ubuntu) samt Tests in der WSL-Shell ausführen.
Stolperstein: Ein natives Windows-PostgreSQL (z. B. vom EDB-Installer) belegt ebenfalls Port 5432. Dann landen Windows-Programme dort statt in WSL (siehe W4). Vorher prüfen:
# PowerShell
Get-Service *postgres*
Läuft ein Dienst wie postgresql-x64-16: stoppen und auf manuellen Start stellen (PowerShell als Administrator: Stop-Service postgresql-x64-16; Set-Service postgresql-x64-16 -StartupType Manual).
✅ Test:
# in WSL (Ubuntu)
pg_lsclusters
systemctl is-enabled postgresql
sudo ss -ltnp | grep 5432
psql "postgresql://raguser:rag123@localhost:5432/vpi" -c "SELECT extversion FROM pg_extension WHERE extname = 'vector';"
Erwartet: 18 main 5432 online, enabled, ss zeigt 127.0.0.1:5432 und [::1]:5432, pgvector 0.8.x. Nach wsl --shutdown und erneutem Öffnen muss der Cluster wieder online sein – sonst läuft systemd nicht (W2).
W4: Zugriff von Windows – pgAdmin, listen_addresses und pg_hba.conf
Die Python-Skripte laufen in WSL und brauchen W4 nicht. W4 betrifft Programme unter Windows wie pgAdmin 4, die von außen auf die Datenbank in WSL zugreifen. Dabei greifen drei Ebenen ineinander:
- Netzwerk Windows ↔ WSL: Kommt das TCP-Paket überhaupt bei der VM an? (Mirrored-Modus, localhost-Forwarding, WSL-IP, Firewall)
listen_addressesinpostgresql.conf: Auf welchen Adressen in der VM nimmt PostgreSQL Verbindungen an?pg_hba.conf: Darf dieser Client (Adresse, Benutzer, Datenbank) sich mit dieser Methode anmelden?
a) Der Normalfall: pgAdmin über 127.0.0.1
In pgAdmin unter Object → Register → Server…, Reiter Connection:
| Feld | Wert | Hinweis |
|---|---|---|
| Host name/address | 127.0.0.1 | Bewusst nicht localhost – siehe unten |
| Port | 5432 | |
| Maintenance database | vpi | Die Standardvorgabe postgres geht auch, vpi ist aber die Datenbank, die uns interessiert |
| Username | raguser | Nicht postgres – siehe unten |
| Password | rag123 | „Save password“ nur auf dem eigenen Rechner |
Das funktioniert ohne Änderung an PostgreSQL: Im Mirrored-Modus teilen sich Windows und WSL 127.0.0.1, im NAT-Modus leitet WSL localhost-Verbindungen weiter. Die Verbindung kommt also von einer Loopback-Adresse – und dafür erlaubt die Standard-pg_hba.conf den Login mit Passwort.
Die drei klassischen Stolpersteine dabei:
localhostwird unter Windows oft zu::1(IPv6). Im Mirrored-Modus wird::1zwischen Windows und WSL nicht unterstützt. Deshalb127.0.0.1eintragen.- Der Superuser
postgreshat kein Passwort. Unter Ubuntu meldet er sich nur lokal perpeeran; über TCP braucht es ein Passwort. Alsoraguserverwenden oder bewusst eines setzen:sudo -u postgres psql -c "\password postgres". - Ein Windows-PostgreSQL „gewinnt“ still. Läuft unter Windows ein eigener Dienst auf 5432, verbindet sich pgAdmin mit diesem – ohne Fehlermeldung. Symptom:
raguserodervpifehlen angeblich. Der nächste Test zeigt, wer auf 5432 lauscht.
✅ Test:
# PowerShell
Test-NetConnection 127.0.0.1 -Port 5432

# Wer lauscht auf Port 5432?
netstat -ano | findstr :5432
Get-NetTCPConnection -LocalPort 5432 -State Listen |
  Select-Object LocalAddress, LocalPort, OwningProcess,
    @{n='Prozess'; e={(Get-Process -Id $_.OwningProcess).ProcessName}}
Erwartet: TcpTestSucceeded : True. Ein Prozess postgres in der Liste wäre ein Windows-PostgreSQL. Im NAT-Modus erscheint ein WSL-Hilfsprozess, im Mirrored-Modus eventuell kein Eintrag.
Der Beweis, dass pgAdmin in WSL gelandet ist – im Query Tool (Datenbank vpi):
✅ Test:
-- pgAdmin, Query Tool, Datenbank vpi
SELECT version(), inet_server_addr(), inet_client_addr(), current_user;
Erwartet: PostgreSQL 18.x on x86_64-pc-linux-gnu (Linux – ein Windows-PostgreSQL meldet … windows … Visual C++), current_user = raguser, inet_client_addr() = 127.0.0.1.
b) listen_addresses – wann 'localhost' reicht und wann nicht
Der Parameter heißt listen_addresses – Plural. Mit listen_address = '*' startet PostgreSQL nach dem nächsten Neustart nicht mehr (Log: unrecognized configuration parameter "listen_address"). Bei einem Reload wird die Zeile nur ignoriert.
Die Datei ist /etc/postgresql/18/main/postgresql.conf. Dort steht #listen_addresses = 'localhost' – das ist auch der eingebaute Standard.
| Situation | listen_addresses | Begründung |
|---|---|---|
| Skripte in WSL, pgAdmin unter Windows im Mirrored-Modus | 'localhost' (Standard) | Windows verbindet über die gemeinsame Loopback-Adresse 127.0.0.1 |
| pgAdmin unter Windows im NAT-Modus, localhost-Forwarding funktioniert (Test in a) erfolgreich) | 'localhost' (Standard) | Das Forwarding bedient auch Ports, die in der VM nur auf localhost gebunden sind |
| NAT-Modus, aber Verbindung nur über die WSL-IP möglich (Forwarding defekt, abgeschaltet, durch VPN/Sicherheitssoftware gestört, oder Zugriff von einer anderen VM bzw. einem Docker-Container) | '*' oder 'localhost,172.x.y.z' | Die Verbindung kommt jetzt auf der eth0-Adresse der VM an, nicht auf Loopback |
Sicherheit: '*' lauscht auf allen Schnittstellen. Im NAT-Modus ist die VM nur vom eigenen Rechner erreichbar. Im Mirrored-Modus hat WSL die echten Adressen des Rechners und wäre aus dem LAN erreichbar – dort nie '*' setzen. Eine fest eingetragene WSL-IP kann sich nach jedem Neustart ändern.
Ändern (nur im NAT-Modus mit Zugriff über die WSL-IP):
# in WSL (Ubuntu)
sudo nano /etc/postgresql/18/main/postgresql.conf
#   Zeile suchen und ändern zu:
#   listen_addresses = '*'          # Achtung: Plural! "listen_addresses"

# listen_addresses wirkt NUR nach einem Neustart (ein Reload genügt nicht)
sudo systemctl restart postgresql
Wurde der Wert einmal per ALTER SYSTEM gesetzt, steht er in postgresql.auto.conf und hat Vorrang vor postgresql.conf. Woher der aktive Wert kommt, zeigt pg_settings:
✅ Test:
# in WSL (Ubuntu)
pg_lsclusters
sudo ss -ltnp | grep 5432
sudo -u postgres psql -c "SHOW listen_addresses;"
sudo -u postgres psql -c "SELECT setting, sourcefile, sourceline FROM pg_settings WHERE name = 'listen_addresses';"
Erwartet: Cluster online. Mit 'localhost' zeigt ss 127.0.0.1:5432 und [::1]:5432, mit '*' 0.0.0.0:5432 und [::]:5432. sourcefile nennt die Datei (leer = Standard). Ist der Cluster down: sudo tail -n 20 /var/log/postgresql/postgresql-18-main.log.
c) pg_hba.conf – wer darf sich wie anmelden?
listen_addresses entscheidet, ob eine Verbindung ankommt. Ob sie angemeldet wird, entscheidet /etc/postgresql/18/main/pg_hba.conf. Die Standardzeilen unter Ubuntu:
# TYPE  DATABASE        USER            ADDRESS                 METHOD
local   all             postgres                                peer
local   all             all                                     peer
host    all             all             127.0.0.1/32            scram-sha-256
host    all             all             ::1/128                 scram-sha-256
# (darunter noch Zeilen für "replication")
local= Unix-Socket (ohne-h). Methodepeer: Der Linux-Benutzer muss wie die Rolle heißen, kein Passwort.host= TCP/IP. Methodescram-sha-256: Anmeldung mit Passwort.- Es gilt die erste passende Zeile. Scheitert sie, wird keine weitere probiert.
Daraus folgt ein Fehler, über den fast jeder stolpert:
# in WSL (Ubuntu), als Linux-Benutzer z. B. "anna"
psql -U raguser -d vpi
# psql: error: … FATAL:  Peer authentication failed for user "raguser"
Ohne -h geht psql über den Unix-Socket → peer → Linux-Benutzer anna ≠ raguser. Lösung: über TCP verbinden, also psql -h localhost -U raguser -d vpi oder die URL aus der Anleitung. Die peer-Zeile nicht ändern.
Eine zusätzliche Zeile braucht man nur, wenn Windows über die WSL-IP im NAT-Modus verbindet. Dann meldet PostgreSQL: FATAL: no pg_hba.conf entry for host "172.30.96.1", user "raguser", database "vpi".
Das tatsächliche Subnetz ermitteln:
# in WSL (Ubuntu)
ip route
#   default via 172.30.96.1 dev eth0 proto kernel
#   172.30.96.0/20 dev eth0 proto kernel scope link src 172.30.98.229
#   → Subnetz 172.30.96.0/20, Windows-Host = 172.30.96.1, WSL-IP = 172.30.98.229
# PowerShell – Gegenprobe von Windows aus
ipconfig            # Adapter "vEthernet (WSL)" bzw. "vEthernet (WSL (Hyper-V firewall))"
wsl hostname -I     # IP-Adresse der WSL-VM (großes I!)
Das Subnetz vergibt Windows; es kann sich nach einem Neustart ändern (meist in 172.16.0.0/12, manchmal 192.168.x.x). Darum geben wir den ganzen Block frei – aber nur für vpi, nur für raguser und nur mit Passwort. Die Zeile kommt ans Ende, unter die Standardzeilen:
# in WSL (Ubuntu)
sudo nano /etc/postgresql/18/main/pg_hba.conf
#   am Ende ergänzen:
# TYPE  DATABASE  USER     ADDRESS          METHOD
host    vpi       raguser  172.16.0.0/12    scram-sha-256

# pg_hba.conf wird mit einem Reload neu eingelesen (kein Neustart nötig)
sudo systemctl reload postgresql
#   oder in psql als Superuser:  SELECT pg_reload_conf();
Niemals trust – auch nicht zum Testen: Damit kommt jeder ohne Passwort als beliebige Rolle hinein, auch als postgres. Ebenso wenig 0.0.0.0/0.
In pgAdmin dann die WSL-IP (wsl hostname -I) als Host eintragen. Weil sie sich ändern kann, ist das nur eine Notlösung – Mirrored-Modus oder localhost-Forwarding sind bequemer.
✅ Test:
# in WSL (Ubuntu)
sudo -u postgres psql -c "SELECT line_number, type, database, user_name, address, netmask, auth_method, error FROM pg_hba_file_rules;"
# PowerShell – Verbindung über die WSL-IP (nur NAT-Modus mit listen_addresses='*')
Test-NetConnection (wsl hostname -I).Trim().Split(' ')[0] -Port 5432
Erwartet: pg_hba_file_rules zeigt die neue Zeile host | {vpi} | {raguser} | 172.16.0.0 | 255.240.0.0 | scram-sha-256. Die Spalte error muss überall leer sein – sonst gilt die ganze Datei nicht und die alten Regeln bleiben aktiv. Test-NetConnection: TcpTestSucceeded : True.
d) Firewall im Mirrored-Modus
Ab Windows 11 22H2 filtert die Hyper-V-Firewall den Verkehr zur WSL-VM. Für pgAdmin auf demselben Rechner ist keine Regel nötig. Soll ein anderer Rechner im LAN zugreifen (für den Workshop nicht empfohlen), nur diesen Port freigeben – nicht pauschal -DefaultInboundAction Allow:
# PowerShell (als Administrator) – nur falls Zugriff aus dem LAN wirklich gewollt ist
New-NetFirewallHyperVRule -Name "WSL-PostgreSQL" -DisplayName "WSL PostgreSQL 5432" `
  -Direction Inbound -VMCreatorId '{40E0AC32-46A5-438A-A0B2-2B479E8F2E90}' `
  -Protocol TCP -LocalPorts 5432
Übersicht: Symptom → Ursache → Lösung
| Symptom | Ursache | Lösung |
|---|---|---|
pgAdmin: connection refused / Timeout auf localhost:5432 | WSL-VM läuft nicht (sie beendet sich nach einiger Zeit ohne offenes Terminal) oder localhost wird zu ::1 aufgelöst | Ubuntu-Fenster öffnen bzw. wsl -d Ubuntu-26.04; in pgAdmin 127.0.0.1 statt localhost |
pgAdmin verbindet, aber role "raguser" does not exist oder Datenbank vpi fehlt | Ein natives Windows-PostgreSQL belegt Port 5432 und „gewinnt“ | Get-NetTCPConnection -LocalPort 5432; Windows-Dienst stoppen oder anderen Port verwenden; Kontrolle mit SELECT version(); |
password authentication failed for user "postgres" | postgres hat unter Ubuntu kein Passwort (nur peer lokal) | Als raguser verbinden oder bewusst \password postgres setzen |
In WSL: Peer authentication failed for user "raguser" | psql ohne -h → Unix-Socket → Regel local … peer | psql -h localhost -U raguser -d vpi bzw. die Verbindungs-URL verwenden |
no pg_hba.conf entry for host "172.…" | Verbindung über die WSL-IP (NAT); keine passende host-Zeile | Zeile host vpi raguser 172.16.0.0/12 scram-sha-256 + systemctl reload postgresql |
Verbindung über WSL-IP: connection refused | listen_addresses = 'localhost' lauscht nicht auf eth0 | listen_addresses = '*' + systemctl restart postgresql (nur NAT-Modus) |
| Gestern ging es über die WSL-IP, heute nicht mehr | Die WSL-IP (und ggf. das Subnetz) hat sich nach dem Neustart geändert | wsl hostname -I neu abfragen; besser Mirrored-Modus bzw. 127.0.0.1 verwenden |
PostgreSQL startet nach Änderung nicht mehr (pg_lsclusters: down) | Unbekannter Parameter (Tippfehler wie listen_address) oder sonstiger Syntaxfehler in postgresql.conf | Log lesen (/var/log/postgresql/postgresql-18-main.log), Zeile korrigieren, systemctl restart postgresql |
Änderung an pg_hba.conf wirkt nicht | Kein Reload, eine frühere Zeile passt zuerst, oder Syntaxfehler (dann gelten die alten Regeln) | SELECT * FROM pg_hba_file_rules; prüfen (Reihenfolge, Spalte error), dann pg_reload_conf() |
Änderung an listen_addresses wirkt nicht | Nur Reload statt Restart, oder Wert per ALTER SYSTEM in postgresql.auto.conf überschrieben | sudo systemctl restart postgresql; sourcefile in pg_settings prüfen |
W5: Python-Umgebung und Projektdateien
Python wie in Schritt 4–5 (Ubuntu) in der WSL-Shell einrichten. Windows-spezifisch ist nur, wo die Dateien liegen:
- Das Projekt gehört ins Linux-Dateisystem:
~/vpi_workshop(=/home/<linux-user>/vpi_workshop). Unter/mnt/c/…liegen die Dateien auf der Windows-Partition und jeder Zugriff geht über eine Dateisystembrücke –pip install, das Laden des Embedding-Modells und das Schreiben vonvektoren.pklwerden dort deutlich langsamer. - Auch das
venvmuss in WSL angelegt werden. Ein unter Windows erzeugtes venv (mitScripts\python.exe) funktioniert in Linux nicht – und umgekehrt. - Dateien von Windows nach WSL bringen: im Explorer die Adresse
\\wsl.localhost\Ubuntu-26.04\home\<linux-user>\vpi_workshopeingeben (ältere Variante:\\wsl$\Ubuntu-26.04\…) und die Dateien hineinziehen – oder in WSL mitcpvon/mnt/ckopieren. Umgekehrt öffnetexplorer.exe .in WSL das aktuelle Verzeichnis im Windows-Explorer. - Mit Windows-Editoren bearbeitete Dateien haben oft Windows-Zeilenenden (CRLF). Für Python, die CSV und das
Modelfileist das unkritisch; Shell-Skripte brechen damit aber mit$'\r': command not foundab (Abhilfe:sudo apt install dos2unix,dos2unix datei.sh). Bequem und sauber: VS Code mit der Erweiterung „WSL“ und in WSLcode .aufrufen.
# in WSL (Ubuntu) – Beispiel: Workshop-Dateien liegen unter Windows im Download-Ordner
mkdir -p ~/vpi_workshop
cp -r /mnt/c/Users/<WindowsName>/Downloads/vpi_workshop/. ~/vpi_workshop/   # Skripte, .env.example, Modelfile, csv_output/
cd ~/vpi_workshop

# danach Schritt 4 und 5 (Ubuntu): apt install python3-venv …, python3 -m venv venv, pip install …
✅ Test:
# in WSL (Ubuntu)
cd ~/vpi_workshop && pwd && ls
source venv/bin/activate
which python
python3 -c "import pandas, psycopg2, openai, torch; print('Pakete OK, torch', torch.__version__)"
python3 -c "import psycopg2; c = psycopg2.connect('postgresql://raguser:rag123@localhost:5432/vpi'); print('DB OK'); c.close()"
Erwartet: pwd zeigt /home/<linux-user>/vpi_workshop (nicht /mnt/c/…), die Skripte, .env.example und der Ordner csv_output sind da, which python zeigt …/venv/bin/python, dazu Pakete OK und DB OK. Danach den Test aus Schritt 5 ausführen.
W6: Ollama – in WSL (empfohlen) oder als Windows-App
Empfehlung: Ollama in WSL installieren, genau wie in Schritt 6 (Ubuntu). Dann bleibt alles in einer Umgebung, die Skripte behalten http://localhost:11434/v1, und es gibt keine Firewall-Fragen.
- NVIDIA-Grafikkarte: WSL 2 reicht die GPU an Linux durch. Nötig ist nur ein aktueller NVIDIA-Treiber unter Windows (mit WSL-Unterstützung, siehe CUDA in WSL). In WSL keinen Linux-NVIDIA-Treiber installieren (
nvidia-driver-…) – das überschreibt die von Windows bereitgestellten Bibliotheken unter/usr/lib/wsl/lib. Ein separates CUDA-Toolkit braucht Ollama nicht. - Ohne (unterstützte) GPU läuft Qwen 3 8B auf der CPU – langsamer, aber funktionsfähig. Dann ist der
memory-Wert aus W2 entscheidend. Die GPU-Unterstützung für AMD- und Intel-Grafik in WSL ist eingeschränkt und hängt von Karte und Treiber ab; wer eine AMD-Karte nutzen will, ist mit der Windows-App (Alternative unten) oft besser bedient. - Mit systemd (W2) richtet das Installationsskript einen Dienst
ollamaein, der mit der WSL-VM startet.
✅ Test:
# in WSL (Ubuntu)
nvidia-smi                       # nur bei NVIDIA-GPU
systemctl is-active ollama
curl -s http://localhost:11434/api/version
ollama run vpi-qwen "Antworte mit einem Wort: Wie heißt die Hauptstadt von Österreich?"
ollama ps
Erwartet: nvidia-smi zeigt die Grafikkarte (bei NVIDIA), active, JSON mit der Version, Antwort Wien. ollama ps zeigt 100% GPU oder 100% CPU. Danach die Tests aus Schritt 6.
Alternative: die Ollama-App für Windows (ollama.com/download/windows) – sinnvoll, wenn Ollama dort schon läuft oder die GPU nur unter Windows unterstützt wird. Dann nicht zusätzlich Ollama in WSL installieren (Port-Konflikt im Mirrored-Modus).
- Mirrored-Modus (Windows 11): Die Windows-App lauscht auf
127.0.0.1:11434, und WSL erreicht sie unter derselben Adresse. Die Skripte bleiben unverändert. Modell und Profil werden in PowerShell angelegt (dasModelfiledazu nach Windows kopieren):ollama pull qwen3:8bundollama create vpi-qwen -f Modelfile. - NAT-Modus (Windows 10): Aus WSL ist Windows nur über die Host-IP erreichbar, und die Windows-App lauscht standardmäßig nur auf
127.0.0.1. Man muss daher (1) unter Windows die UmgebungsvariableOLLAMA_HOST=0.0.0.0:11434setzen (Ollama im Infobereich beenden, „Umgebungsvariablen für dieses Konto bearbeiten“, Variable anlegen, Ollama neu starten), (2) eine Firewall-Regel anlegen, die Port 11434 nur für das WSL-Netz öffnet –0.0.0.0macht Ollama sonst im ganzen LAN erreichbar, ohne jede Authentifizierung – und (3) in den Skriptenlocalhost:11434durch die Host-IP ersetzen. Weil sich diese IP ändern kann, ist das der umständlichste Weg.
# PowerShell (als Administrator) – nur NAT-Modus mit Windows-Ollama
New-NetFirewallRule -DisplayName "Ollama fuer WSL" -Direction Inbound -Protocol TCP `
  -LocalPort 11434 -RemoteAddress 172.16.0.0/12 -Action Allow
# in WSL (Ubuntu) – Host-IP ermitteln und in .env eintragen
WINHOST=$(ip route show default | awk '{print $3}')
echo $WINHOST
sed -i "s#^OLLAMA_URL=.*#OLLAMA_URL=http://$WINHOST:11434/v1#" ~/vpi_workshop/.env
✅ Test:
# in WSL (Ubuntu)
# Mirrored-Modus:
curl -s http://localhost:11434/api/version
# NAT-Modus:
curl -s http://$(ip route show default | awk '{print $3}'):11434/api/version
grep OLLAMA_URL ~/vpi_workshop/.env
Erwartet: JSON mit der Ollama-Version. Connection refused: OLLAMA_HOST nicht gesetzt oder Ollama nicht neu gestartet. Timeout: Firewall-Regel fehlt oder WSL-Subnetz außerhalb von 172.16.0.0/12.
W7: Pipeline ausführen und Gesamttest
Jetzt folgen Schritt 7–11 (Ubuntu) und der Gesamttest unverändert in der WSL-Shell:
# in WSL (Ubuntu)
cd ~/vpi_workshop && source venv/bin/activate
cp -n .env.example .env            # Zugangsdaten (Schritt 7)
(cd csv_output && python merge.py)
python 01_csv_zu_text.py
python 02_text_zu_vektoren.py
python 03_vektoren_nach_pgvector.py
psql "postgresql://raguser:rag123@localhost:5432/vpi" -c "REINDEX INDEX vpi_embeddings_embedding_idx;"
python 07_rag_abfrage.py "Welches Produkt hatte im Dezember 2023 den höchsten Preisanstieg?"
Zum Schluss der Test von der Windows-Seite aus, ohne WSL-Fenster:
✅ Test:
# PowerShell
# 1) Ports erreichbar? (Ollama-Port 11434 nur bei Ollama in WSL bzw. Windows-App im Mirrored-Modus)
Test-NetConnection 127.0.0.1 -Port 5432
Test-NetConnection 127.0.0.1 -Port 11434

# 2) Datenbank und Pipeline in WSL von Windows aus anstoßen
#    -e startet das Programm direkt (ohne Linux-Shell), dadurch bleiben die Argumente intakt;
#    <linux-user> durch den eigenen Linux-Benutzernamen ersetzen
wsl -d Ubuntu-26.04 -e psql "postgresql://raguser:rag123@localhost:5432/vpi" -c "SELECT count(*) FROM vpi_embeddings;"
wsl -d Ubuntu-26.04 --cd /home/<linux-user>/vpi_workshop -e ./venv/bin/python 07_rag_abfrage.py "Wie hat sich der Butterpreis im Jahr 2024 entwickelt?"
Erwartet: zweimal TcpTestSucceeded : True, count = 3276 und eine deutsche Antwort mit Quellen. In pgAdmin liefert SELECT count(*) FROM vpi_embeddings; ebenfalls 3276 – Windows und WSL sehen dieselbe Datenbank.
Tipp: Die WSL-VM fährt nach einiger Zeit ohne offene Sitzung herunter, mit ihr PostgreSQL und Ollama; pgAdmin meldet dann connection refused. Ein Ubuntu-Terminal öffnen (oder wsl -d Ubuntu-26.04) startet alles wieder.
Fehlerbehebung
| Problem | Lösung |
|---|---|
password authentication failed for user "raguser" | Passwort neu setzen: ALTER ROLE raguser PASSWORD 'rag123'; (als Superuser) |
role "postgres" does not exist (macOS) | Bei Homebrew ist dein macOS-Benutzer der Superuser: psql postgres |
extension "vector" is not available | Ubuntu: postgresql-18-pgvector installieren; macOS: brew install pgvector und PostgreSQL neu starten |
permission denied to create extension "vector" | Die Extension muss ein Superuser in der Datenbank vpi anlegen (Schritt 3) |
psql: command not found (macOS) | PATH aus Schritt 1 setzen und Terminal neu öffnen |
| Verbindung zu Ollama verweigert | Ubuntu: sudo systemctl start ollama; macOS: brew services start ollama oder ollama serve |
| Antworten sind langsam | Erste Antwort lädt das Modell in den RAM (10–30 s); ohne GPU braucht Qwen 3 8B einige Sekunden pro Antwort |
| Doppelte Treffer in der Suche | Skript 03 wurde mehrfach ausgeführt → TRUNCATE vpi_embeddings; und neu importieren |
Fazit
Mit PostgreSQL, pgvector, einem kleinen Embedding-Modell und einem lokalen LLM entsteht in einer Stunde ein vollständiges RAG-System, das Fragen zu echten österreichischen Preisdaten mit nachvollziehbaren Quellen beantwortet. Die eigene Rolle raguser sorgt dafür, dass die Anwendung nur das darf, was sie braucht. Das Muster lässt sich auf beliebige eigene Daten übertragen: Texte erzeugen, einbetten, in pgvector speichern – und das LLM nur noch formulieren lassen.